
لماذا Jev Model
قد ينجح نموذج لغوي في كتابة رد مقنع، ثم يفشل في أهم شيء يحتاجه كودك: إعادة قيمة يمكن الوثوق بنوعها. إذا طلبت من LLM تصنيف تذكرة دعم، فقد تحصل على كلمة إضافية، أو JSON غير صالح، أو شرح طويل لا يناسب شرط if.
يحل Jev Model هذه المشكلة من زاوية مختلفة. بدلاً من توليد نص، يقيّم حالة state ويعيد قراراً مهيكلاً مع احتمالات. في هذا الدليل ستبني طلباً واحداً يحدد قسم التذكرة، ويقيس شدتها، ويتحقق من طلب التصعيد البشري. تم اختبار الأمثلة على HTTP API الموثق من TypeSafe، مع افتراض Python 3.10+ إذا استخدمت كود Python المرفق.
ما هو Jev Model ولماذا تحتاجه؟
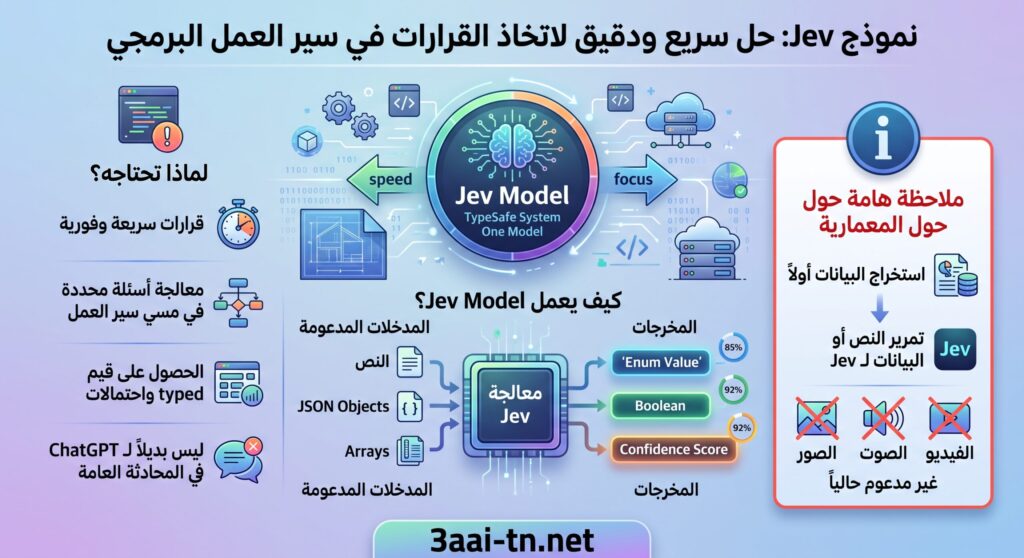
Jev Model هو أول نموذج System One Model (نموذج قرارات سريع ومركّز) من TypeSafe. فكرته الأساسية ليست منافسة ChatGPT في المحادثة أو كتابة الكود، بل معالجة أسئلة صغيرة ومحددة داخل سير عمل برمجي. ترسل الحالة، ثم تحدد نوع الإجابة الممكنة، وتحصل على قيمة typed (محددة النوع) واحتمالات مرتبطة بها.
يدعم Jev حالياً إدخال النص، وJSON objects، وarrays التي تحتوي على نصوص. لا يدعم الصور أو الصوت أو الفيديو في الوقت الحالي.2 هذه النقطة مهمة عند تصميم المعمارية: استخرج النص أو البيانات المطلوبة أولاً بأداة أخرى، ثم مررها إلى Jev لاتخاذ القرار.
تقدم TypeSafe ثلاث بدائيات أساسية:
- Choice (اختيار): اختيار عنصر واحد من قائمة محددة، مثل
billingأوshippingأوreturns. - Score (تقييم تدريجي): وضع الحالة على مقياس تصفه أنت، مثل مستويات خطورة العطل.
- Noul (نعم/لا احتمالي): قياس احتمال صحة عبارة واحدة، من
0للنفي إلى1للإثبات.
💡 نصيحة للمحترفين (Pro Tip): لا تسأل Jev سؤالاً مركباً من خمس قرارات. فككه إلى أسئلة ذرية، ثم ادمج نتائجها في كودك. بهذه الطريقة تبقى أوزان القرار والعتبات ظاهرة وقابلة للاختبار.
الفرق المعماري عن LLM التوليدي أن Jev لا يعيد فقرة تحتاج إلى parsing. أنت تحدد الخيارات أو المستويات مسبقاً، لذلك لا يستطيع النموذج اختراع خيار خارج القائمة في إجابة Choice. كما أن TypeSafe تصمم المخرجات لتتضمن احتمالات، وتوفر confidence مع Choice وScore.
Jev Model مقابل LLM تقليدي
اختيار Jev لا يعني استبدال كل نموذج لغوي في مشروعك. استخدم النموذج المناسب لشكل المهمة:
| المعيار | Jev Model | LLM توليدي تقليدي |
|---|---|---|
| المخرج | Choice أو Score أو Noul مهيكل | نص أو JSON مولد |
| أفضل استخدام | تصنيف، توجيه، كشف شرط، ترتيب | شرح، كتابة، تلخيص، توليد كود |
| التحكم بالأنواع | الخيارات والمستويات محددة مسبقاً | تحتاج إلى validation وparsing |
| التعامل مع عدم اليقين | احتمالات وconfidence مدمجة | تقدير الثقة يحتاج إلى تصميم إضافي |
| التوليد الحر | غير متاح؛ لا يكتب نصاً | متاح ومرن |
| الصور والصوت والفيديو | غير مدعومة حالياً | تعتمد على النموذج والواجهة |
| مكانه في المعمارية | داخل if أو router أو queue | واجهة المستخدم أو طبقة التوليد |
تعلن TypeSafe أن Jev مصمم لزمن استجابة يتراوح تقريباً بين 70 و500 ملي ثانية، ولتكلفة إدخال منشورة قدرها 0.042 دولار لكل مليون وحدة نصية، مع كون مخرجاته المهيكلة منخفضة التكلفة جداً وفق إعلان الشركة.1 هذه أرقام من الشركة وليست benchmark مستقلاً، لذلك اختبر زمن الشبكة، حجم الحالة، وإعادة المحاولة في بيئتك قبل الالتزام بها.
⚠️ تحذير / فخ برمجي (Gotcha): كلمة “calibrated” لا تعني أن كل إجابة صحيحة. تعني أن الاحتمالات مصممة لتعكس عدم اليقين على مستوى مجموعة من التنبؤات. اترك مسار مراجعة بشرية عندما تكون تكلفة الخطأ مرتفعة.
كيف تبدأ باستخدام Jev عبر HTTP API؟
المتطلبات
ستحتاج إلى حساب TypeSafe ومفتاح API، إضافة إلى curl أو Python 3.10+. خزّن المفتاح في متغير بيئة، ولا تضعه داخل ملفات WordPress أو JavaScript الذي يصل إلى المتصفح.
# Linux أو macOS
export TYPESAFE_API_KEY="ضع_مفتاحك_هنا"

# تأكد من وجود المفتاح دون طباعته
if [ -z "$TYPESAFE_API_KEY" ]; then
  echo "TYPESAFE_API_KEY غير مضبوط" >&2
  exit 1
fi
يستخدم المثال التالي endpoint الرسمي POST /v1/systemone، ويضم الأنواع الثلاثة في طلب واحد. كل سؤال مستقل عن الآخر، لكنه يرى نفس state.
curl -sS https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {
      "message": "تم خصم المبلغ مرتين، ولا أستطيع تسجيل الدخول منذ أمس.",
      "channel": "email",
      "customer_tier": "business"
    },
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "إلى أي قسم يجب توجيه التذكرة؟",
        "criteria": {
          "billing": "مشكلة دفع أو خصم أو فاتورة",
          "account": "تسجيل الدخول أو الوصول إلى الحساب",
          "technical": "عطل في وظيفة أو تكامل تقني",
          "other": "لا تنتمي التذكرة بوضوح إلى الأقسام الأخرى"
        }
      },
      "severity": {
        "type": "score",
        "instructions": "قيّم خطورة المشكلة على فريق الدعم.",
        "criteria": [
          "استفسار عادي أو مشكلة تجميلية مع workaround واضح",
          "ميزة متأثرة، لكن يمكن للعميل إكمال جزء مهم من العمل",
          "العميل متوقف عن العمل أو توجد مخاطرة مالية أو أمنية واضحة"
        ]
      },
      "needs_human": {
        "type": "noul",
        "instructions": "هل تحتاج هذه التذكرة إلى تدخل بشري مباشر؟",
        "criteria": {
          "true": "المشكلة مالية أو حساسة أو لا يمكن للبوت حلها بأمان",
          "false": "يمكن التعامل معها آلياً دون مخاطرة واضحة"
        }
      }
    }
  }'
بنية الطلب ثابتة: state هي البيانات التي تريد تقييمها، وmodel يحدد jev-latest، وquestions خريطة تسمي مفاتيحها أنت. تعود الإجابات تحت المفاتيح نفسها، وهذا يسهل ربطها بنموذج البيانات في تطبيقك.
فهم Choice و Score و Noul في الكود
1. Choice للتوجيه والتصنيف
تستخدم Choice عندما تكون الإجابة عضواً واحداً من قائمة لا تحمل ترتيباً. في المثال السابق ستجد choice، وتوزيع probabilities لكل قسم، وconfidence يلخص مدى تركّز التوزيع.
إذا كانت النتيجة billing باحتمال 0.61 وaccount باحتمال 0.35، فلا تتعامل معها كقرار يقيني. يمكنك إرسال نسخة إلى فريق الفوترة عندما يتجاوز الاحتمال 0.25، أو تحويلها إلى مراجعة بشرية عندما تنخفض الثقة عن عتبة محددة.
أضف خيار other أو none عندما لا تغطي قائمتك كل الحالات. تقبل Choice حتى 255 خياراً وفق مرجع API، لكن القوائم الكبيرة تحتاج إلى تصميم تصنيف هرمي حتى لا تصبح أوصاف الخيارات متشابهة.
2. Score لقياس الشدة أو الأولوية
تستخدم Score عندما تكون الإجابة على طيف مرتب. اكتب مستويات تصف حالات ملموسة، لا أوصافاً غامضة مثل “منخفض” و“متوسط” و“مرتفع” فقط. يعيد Jev قيمة قد تقع بين مستويين لأنها تمثل متوسطاً مرجحاً حسب الاحتمالات.
في مثال المستويات الثلاثة، قد يعيد score: 1.43 مع احتمال 0.57 للمستوى الأول و0.43 للمستوى الثاني. الرقم ليس نسبة مئوية؛ هو موقع على خط المستويات. طبّع القيمة إذا أردت دمجها مع مقاييس أخرى:
# Python 3.10+؛ تحويل Score إلى نطاق 0..1
score = 1.43
number_of_levels = 3
normalized = score / (number_of_levels - 1 )

# normalized = 0.715
if normalized >= 0.70:
    priority = "high"
elif normalized >= 0.40:
    priority = "medium"
else:
    priority = "low"
اكتب مستوياتك كحالات يمكن للمطور مراجعتها في الاختبارات. مستوى “العميل متوقف عن العمل وتوجد مخاطرة مالية” أفضل بكثير من “خطورة عالية”، لأنه يحدد سبب التصنيف وحدوده.
3. Noul للتحقق من شرط واحد
Noul مناسب لسؤال نعم/لا واحد، لكنه لا يعيد boolean مباشرة. يعيد رقماً بين 0 و1 يمثل احتمال أن تكون الإجابة “نعم”. استخدم عتبتين بدلاً من عتبة واحدة في القرارات الحساسة:
# لا تحوّل كل قيمة إلى True/False دون مسار للغموض
needs_human = 0.78

if needs_human >= 0.80:
    route = "human"
elif needs_human <= 0.20:
    route = "automation"
else:
    route = "manual_review"
القيمة القريبة من 0.5 ليست “نصف نعم”. غالباً هي حالة غير واضحة أو دليل متعارض. مسار manual_review يمنعك من تحويل عدم اليقين إلى قرار آلي خاطئ.
مثال Python كامل لبناء خدمة فرز تذاكر
إذا أردت إبقاء التكامل مستقلاً عن SDK، استخدم HTTP مباشرة مع requests. هذا يجعل شكل الطلب والاستجابة واضحاً، ويصلح كنقطة بداية لخدمة Flask أو WordPress plugin يتحدث مع backend آمن.
# Python 3.10+
import os
import requests

API_URL = "https://api.typesafe.ai/v1/systemone"


def triage_ticket(message: str ) -> dict:
    api_key = os.environ["TYPESAFE_API_KEY"]

    payload = {
        "model": "jev-latest",
        "state": {"message": message},
        "questions": {
            "department": {
                "type": "choice",
                "instructions": "إلى أي فريق تنتمي هذه التذكرة؟",
                "criteria": {
                    "billing": "الدفع أو الفواتير أو الخصم",
                    "account": "الدخول أو الحساب أو الصلاحيات",
                    "technical": "عطل في المنتج أو التكامل",
                    "other": "لا يوجد تطابق واضح"
                }
            },
            "severity": {
                "type": "score",
                "instructions": "قيّم أثر المشكلة على قدرة العميل على العمل.",
                "criteria": [
                    "لا يوجد توقف ويمكن استخدام workaround",
                    "جزء من العمل متأثر لكن المسار الأساسي متاح",
                    "العميل متوقف أو توجد مخاطرة مالية واضحة"
                ]
            },
            "needs_human": {
                "type": "noul",
                "instructions": "هل يجب أن يراجع بشري هذه التذكرة؟",
                "criteria": {
                    "true": "تحتاج إلى تعاطف أو صلاحية أو قرار حساس",
                    "false": "يمكن للبوت التعامل معها بأمان"
                }
            }
        }
    }

    response = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {api_key}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=10,
    )
    response.raise_for_status()
    answers = response.json()["answers"]

    department = answers["department"]
    severity = answers["severity"]
    human_probability = answers["needs_human"]["noul"]

    # القرار النهائي يبقى في كودك، لا داخل prompt غامض.
    normalized_severity = severity["score"] / 2
    if human_probability >= 0.80 or normalized_severity >= 0.80:
        route = "human_priority"
    elif human_probability <= 0.20 and normalized_severity < 0.50:
        route = "bot"
    else:
        route = "manual_review"

    return {
        "department": department["choice"],
        "department_confidence": department["confidence"],
        "severity": severity["score"],
        "severity_confidence": severity["confidence"],
        "human_probability": human_probability,
        "route": route,
    }


if __name__ == "__main__":
    print(triage_ticket("تم تحصيل رسوم مرتين ولا أستطيع الدخول إلى لوحة التحكم."))
ثبّت الاعتمادية قبل التشغيل عبر python -m pip install requests. في الإنتاج، أضف logging دون تسجيل مفتاح API أو محتوى حساس، واحفظ الاستجابة الخام عند فشل التحقق حتى تستطيع تحليل سبب التوجيه. لا تجعل WordPress يستدعي TypeSafe من المتصفح؛ نفّذ الطلب في backend أو في إضافة تستخدم endpoint داخلياً مع حماية للصلاحيات.
للمهام التي تتكرر، اجمع الأسئلة في طلب واحد. تقول TypeSafe إن الأسئلة في الطلب نفسه تُقيّم بالتوازي وعلى الحالة نفسها، لذلك لا تحتاج إلى ثلاث استدعاءات مستقلة لمجرد الحصول على Choice وScore وNoul. أما إذا كانت الإجابة الأولى ستحدد البيانات التي تجمعها قبل السؤال التالي، فافصل الطلبين لأن الاعتماد هنا حقيقي.
أخطاء شائعة وكيفية تصحيحها (Common Pitfalls)
تحويل Jev إلى chatbot
Jev لا يكتب إجابة للمستخدم ولا يشرح خطوات التفكير. إذا كان منتجك يحتاج إلى رسالة طبيعية، استخدم Jev للتصنيف أو التحقق، ثم مرر القرار إلى قالب ثابت أو LLM توليدي. لا تطلب منه “حل المشكلة وكتابة الرد وتحديد الأولوية” في سؤال واحد.
كتابة معايير متداخلة
إذا كان وصف billing وaccount يذكر كلمة “اشتراك” نفسها دون تحديد، ستتوزع الاحتمالات. افصل الخيارات بعبارات what it covers وnot_for وأمثلة قصيرة. اختبر كل rubric على بيانات معروفة قبل إطلاقه.
اعتبار confidence ضماناً للصحة
الثقة أداة للتوجيه، وليست بديلاً عن مجموعة اختبار. أنشئ عينات موسومة يدوياً، راقب false positives وfalse negatives، ثم عدّل الأوصاف والعتبات. احتفظ بمسار تصعيد عندما تكون الثقة منخفضة.
وضع عتبة واحدة لكل شيء
عتبة 0.5 قد تكون مناسبة لتجربة داخلية، لكنها ليست قاعدة إنتاج عامة. حدّد تكلفة الخطأ: تحويل فاتورة إلى الفريق الخطأ يختلف عن الموافقة على استرداد مالي. اجعل العتبات إعدادات قابلة للتغيير واختبرها على بيانات حقيقية منزوعة الحساسية.
تجاهل أخطاء الشبكة والحدود
تعامل مع 401 على أنه مشكلة مفتاح أو صلاحية، ومع 400 على أنه خطأ في شكل state أو questions. عند 429 Too Many Requests أو 529 Overloaded استخدم exponential backoff، وهو سلوك تقول الوثائق إن SDK الرسمي يديره تلقائياً بسياسة إعادة المحاولة الافتراضية. ضع timeout واضحاً، ولا تعيد طلباً قد يسبب إجراءً مالياً دون idempotency أو مراجعة.
رأي عملي: هل يستحق Jev الاستخدام في الإنتاج؟
نعم، إذا كانت مشكلتك قراراً صغيراً ومتكرراً داخل سير عمل واضح. فرز التذاكر، استخراج نوع الطلب، كشف وجود بيانات شخصية، تقييم شدة عطل، أو اختيار مسار معالجة هي حالات مناسبة. الميزة الكبرى أن schema القرار يعيش في كودك، وأن الاحتمالات تساعدك على التفريق بين الحالة الواضحة والحالة التي تحتاج إلى إنسان.
لا تستخدمه وحده لكتابة مقالات، أو الرد على العملاء، أو تحليل مستند طويل يحتاج إلى استدلال متعدد الخطوات. كذلك لا تفترض أن سرعة الخدمة تلغي زمن الشبكة أو تكلفة مراقبة الجودة. ابدأ بمسار shadow mode: أرسل الحالات إلى Jev، لكن لا تغيّر قرار النظام، ثم قارن النتائج بعينات مراجعة بشرية.
خطوتك التالية
أنشئ مجموعة من 50 تذكرة مجهولة الهوية، واكتب rubric واضحاً لكل Choice و Score و Noul. شغّل طلباً واحداً عليها، وسجّل القرار والاحتمالات وقرار المراجع البشري. إذا كانت النتائج مستقرة، أضف manual_review قبل ربط Jev بأي إجراء حساس.
ابدأ بالتصنيف فقط، ثم أضف قياس الشدة والتحقق من التصعيد. بهذه الطريقة تختبر قيمة Jev Model في نقطة صغيرة من نظامك، بدلاً من تحويل التطبيق كله إلى تجربة لا تعرف أين أخطأت.
- الأسئلة الشائعة ومخطط البيانات (FAQ Schema JSON-LD)
ما هو Jev Model؟
Jev Model هو أول System One Model من TypeSafe، ومخصص لإرجاع قرارات مهيكلة واحتمالات بدلاً من توليد نص حر. يستخدمه المطور للتصنيف، والتقييم، والتحقق من شروط نعم/لا داخل سير العمل البرمجي.
ما الفرق بين Choice وScore وNoul في Jev؟
تختار Choice عنصراً من قائمة، ويقيس Score حالة على مستويات مرتبة، بينما يعيد Noul احتمال صحة عبارة نعم/لا. يمكنك إرسال الأنواع الثلاثة في استدعاء واحد.
هل يستطيع Jev توليد نص أو التعامل مع الصور؟
لا. Jev مصمم للقرارات المهيكلة، ولا يولد ردوداً نصية أو كوداً. ووفق التوثيق الحالي، يقبل النص وJSON والـ arrays النصية، بينما الصور والصوت والفيديو غير مدعومة حالياً.
كيف أتعامل مع احتمال Jev غير الواضح؟
ضع عتبتين ومسار مراجعة بشرية بينهما. لا تحوّل قيمة Noul القريبة من 0.5 إلى قرار آلي مباشر، ولا تعتبر confidence ضماناً لصحة الحالة الفردية.
كود FAQ Schema جاهز للنسخ في WordPress
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "ما هو Jev Model؟",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "Jev Model هو أول System One Model من TypeSafe، ومخصص لإرجاع قرارات مهيكلة واحتمالات بدلاً من توليد نص حر."
      }
    },
    {
      "@type": "Question",
      "name": "ما الفرق بين Choice وScore وNoul في Jev؟",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "تختار Choice عنصراً من قائمة، ويقيس Score حالة على مستويات مرتبة، بينما يعيد Noul احتمال صحة عبارة نعم أو لا."
      }
    },
    {
      "@type": "Question",
      "name": "هل يستطيع Jev توليد نص أو التعامل مع الصور؟",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "لا. Jev مخصص للقرارات المهيكلة ولا يولد ردوداً نصية أو كوداً، كما أن الصور والصوت والفيديو غير مدعومة حالياً."
      }
    },
    {
      "@type": "Question",
      "name": "كيف أتعامل مع احتمال Jev غير الواضح؟",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "استخدم عتبتين ومسار مراجعة بشرية بينهما، ولا تحول قيمة Noul القريبة من 0.5 إلى قرار آلي مباشر."
      }
    }
  ]
}
ملاحظة : الأسعار والأداء وحالة دعم الوسائط قابلة للتغير، لذلك راجع صفحات TypeSafe الرسمية قبل نشر المقال أو تحديثه.